Una factura de AWS que crece mes a mes casi nunca crece porque el negocio esté creciendo al mismo ritmo. Crece porque nadie apaga lo que dejó de usarse, porque las máquinas se dimensionaron a ojo el primer día y porque se paga a precio de tarifa un consumo que lleva dos años siendo el mismo.
FinOps es la práctica que pone orden en eso. Para una pyme, lo relevante es que las palancas que más dinero mueven no tocan ni una línea de código ni la experiencia de nadie.
Aquí explicamos qué es FinOps, cuáles son esas palancas, en qué orden se aplican y qué esperar de cada una.
En pocas palabras:
- La factura sube sola por recursos olvidados, máquinas sobredimensionadas y consumo estable pagado a precio de tarifa.
- Las palancas van en orden: limpiar, ajustar tamaños, comprometer lo estable y después cambiar procesador, disco y almacenamiento.
- Ninguna toca el código ni lo que ven tus clientes.
- El ahorro solo se mantiene si alguien revisa el gasto cada trimestre.
Qué es FinOps
FinOps es un marco operativo y una práctica cultural que busca sacar el máximo valor de negocio al gasto en tecnología. Da visibilidad del coste a quien toma las decisiones técnicas y reparte la responsabilidad económica entre ingeniería, finanzas y dirección.
Dicho en corto, es dejar de mirar la factura de la nube como un recibo que llega a fin de mes y empezar a tratarla como una variable que se diseña.
El término lo mantiene la FinOps Foundation, proyecto bajo LF Projects (el paraguas de la Linux Foundation). Publica el marco de referencia y un modelo de madurez en tres niveles, del reactivo al preventivo.
También impulsa FOCUS, una especificación abierta para que los datos de facturación de AWS, Azure, Google Cloud y Oracle tengan el mismo formato. Para una pyme con un solo proveedor FOCUS importa poco; el modelo de madurez sí, porque describe el camino que hay que recorrer.
Por qué la factura sube sola
En los entornos que revisamos, el sobrecoste casi siempre viene de las mismas cinco fuentes, y ninguna es un fallo del producto.
- Recursos huérfanos. Discos de máquinas que se borraron hace meses, instantáneas acumuladas sin política de caducidad, balanceadores sin nada detrás, direcciones IPv4 públicas reservadas y sin uso. AWS cobra la IPv4 pública a 0,005 dólares por hora (unos 0,0045 €, al cambio del BCE del 12 de octubre de 2026) esté en uso o esté ociosa, según su tarifa pública de VPC consultada en septiembre de 2026, así que las que sobran se pagan igual.
- Sobredimensionado de origen. Alguien eligió el tamaño de instancia el primer día, con prisa y sin datos, y ese tamaño ya nadie lo ha vuelto a tocar aunque la aplicación use un tercio de la memoria.
- Todo a precio de tarifa. Una parte del consumo es perfectamente estable y previsible, pero se paga bajo demanda, que es la modalidad más cara de todas.
- Entornos de no producción encendidos siempre. Preproducción, integración y las máquinas de pruebas suelen funcionar los siete días de la semana para usarse cuarenta horas.
- Tráfico y servicios de red mal colocados. Salidas a internet que pasan por una pasarela NAT que se paga por hora y por gigabyte procesado, o transferencias entre zonas que se podrían evitar con un cambio de ubicación.
Las palancas que bajan la factura sin tocar el producto
El orden importa. Se aplican de arriba abajo porque cada una reduce la base sobre la que actúa la siguiente.
Comprometer consumo antes de limpiar y ajustar es la forma más habitual de firmar un descuento sobre una máquina que sobraba.
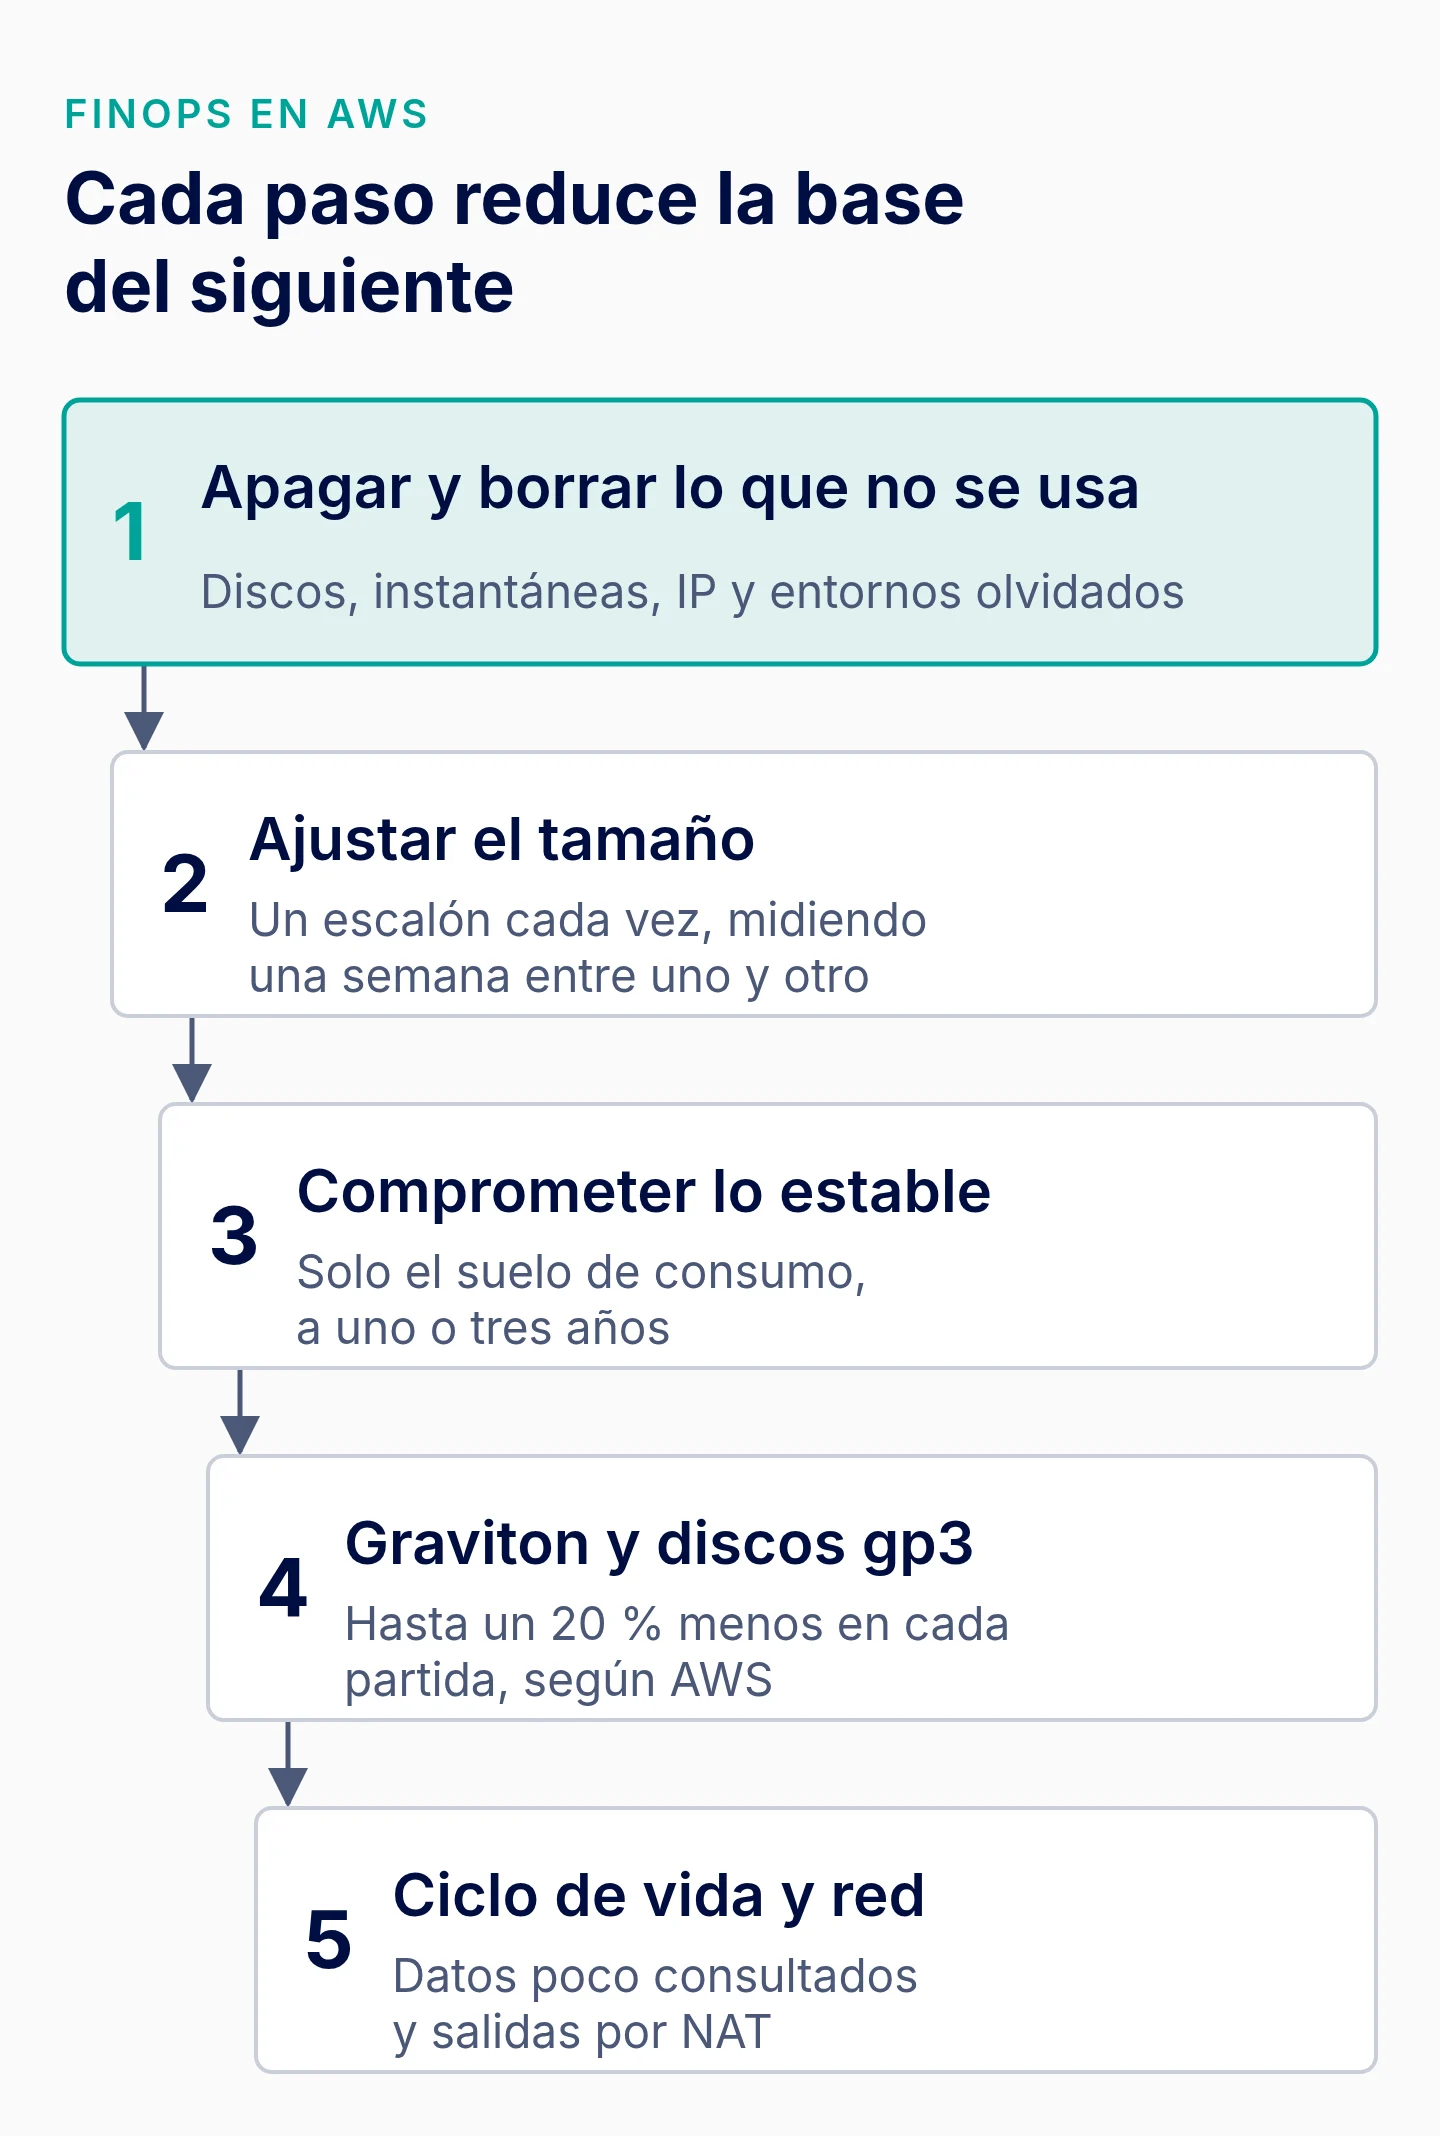
1. Apagar y borrar lo que no se usa
Es la palanca más rentable y la que más se descuida, porque es trabajo de inventario más que técnico. Se listan y se retiran:
- Volúmenes sin adjuntar.
- Instantáneas anteriores a la política de retención.
- Direcciones públicas ociosas y balanceadores vacíos.
- Entornos que nadie reclama.
Los que solo se usan en jornada laboral se apagan por horario. Un entorno de pruebas encendido de ocho a ocho de lunes a viernes cuesta menos de la mitad que uno encendido siempre, sin cambiar nada en la aplicación.
2. Ajustar el tamaño al consumo real
Con las métricas de uso de CPU y memoria de las últimas semanas se baja cada instancia al tamaño que de verdad necesita.
AWS ofrece recomendaciones automáticas de redimensionado sin coste adicional. Son un punto de partida decente siempre que alguien las revise con criterio, porque el histórico de un servicio con picos estacionales engaña.
Aquí el riesgo es real pero acotado. Se gestiona bajando un escalón cada vez y midiendo una semana antes del siguiente.
3. Comprometer el consumo que ya sabes que vas a tener
Sobre la base ya limpia y ajustada, lo que queda estable se compromete a uno o tres años a cambio de descuento. AWS anuncia ahorros de hasta el 72 % frente al precio bajo demanda con sus planes de ahorro, según su página oficial consultada en septiembre de 2026.
El matiz que suele faltar es que ese máximo corresponde a compromisos de tres años pagados por adelantado y a familias concretas. En una pyme lo sensato es comprometer solo el suelo de consumo, el que no baja ni en agosto, y dejar el resto bajo demanda.
4. Cambiar de familia de procesador y de tipo de disco
Dos cambios de bajo riesgo con efecto inmediato:
- Procesadores Graviton. Mover las cargas compatibles a instancias Graviton, que AWS sitúa hasta un 20 % por debajo de las equivalentes x86 en su página oficial de septiembre de 2026. En cargas interpretadas o contenedorizadas suele bastar con recompilar la imagen.
- Discos gp3. Pasar los volúmenes de gp2 a gp3, con hasta un 20 % menos por gigabyte según AWS (0,08 frente a 0,10 dólares por gigabyte y mes, unos 0,072 frente a 0,089 € al cambio del BCE del 12 de octubre de 2026) y un rendimiento base garantizado de 3.000 IOPS independiente del tamaño del disco.
5. Ciclo de vida del almacenamiento y limpieza de rutas de red
Los objetos que nadie consulta desde hace meses no tienen por qué estar en la clase de almacenamiento más cara, y una política de ciclo de vida los mueve sola.
En red, revisar qué sale por la pasarela NAT y qué se puede resolver con puntos de acceso privados suele quitar una partida entera de la factura.
| Palanca | Esfuerzo | Riesgo para el servicio | Qué esperar |
|---|---|---|---|
| Apagar y borrar lo no usado | Bajo, pero exige inventario | Muy bajo | Suele ser el primer recorte grande |
| Ajustar tamaños | Medio, requiere métricas | Medio, se controla por pasos | Recorte sostenido en cómputo |
| Comprometer consumo estable | Bajo una vez limpiado | Bajo, el riesgo es financiero | Hasta 72 % según AWS en el tramo comprometido |
| Graviton y gp3 | Medio en Graviton, bajo en gp3 | Bajo | Hasta 20 % en cada partida según AWS |
| Ciclo de vida y red | Medio | Bajo | Elimina partidas completas poco visibles |
Un escenario típico: la factura subió y el negocio no
Una empresa industrial de unas setenta personas con su ERP, un portal de pedidos para distribuidores y un entorno de preproducción en AWS.
La factura había pasado de una cifra que nadie discutía a otra que en dirección ya se comentaba en cada cierre, mientras el número de pedidos llevaba dos años plano. El equipo interno son dos personas que atienden puestos, red y aplicaciones, y ninguna tenía asignado mirarla.
Al desglosar el gasto por etiqueta y por servicio aparecieron tres cosas:
- Preproducción consumía casi lo mismo que producción y se usaba dos tardes por semana.
- Las instancias del ERP se habían dimensionado para una migración que ya había terminado y trabajaban muy por debajo de su capacidad.
- No había ni un solo compromiso de consumo, pese a que el suelo de gasto llevaba veinticuatro meses siendo idéntico.
Lo que se hizo, por este orden:
- Apagar preproducción fuera de horario y borrar discos e instantáneas huérfanas.
- Bajar dos escalones el tamaño de las instancias del ERP, midiendo una semana entre cada paso.
- Pasar todos los volúmenes a gp3.
- Solo entonces, comprometer a un año el suelo de consumo resultante.
Ningún cambio afectó a cómo los distribuidores usan el portal.
Además del importe cambió el gobierno: etiquetado obligatorio por entorno y proyecto, un presupuesto con aviso automático al superar el umbral del mes y una revisión trimestral con dirección en la que se enseña el gasto por proyecto y no un total sin contexto.
Lo que FinOps no arregla
FinOps optimiza lo que hay, pero no corrige un planteamiento equivocado. Si una aplicación mantiene encendidas máquinas grandes porque no sabe escalar, el ahorro tiene un techo bajo y lo que toca es revisar la arquitectura.
Y hay un caso en el que ninguna palanca es suficiente. Cuando la carga es estable, previsible, funciona a todas horas y no necesita elasticidad, la nube pública es cara por definición, porque lo que se paga es precisamente la flexibilidad de poder apagarla.
En esos casos toca comparar la nube con otros modelos de infraestructura, y lo hemos desarrollado en nube o servidor propio.
Un servidor propio o una nube privada bien operados salen a menudo por menos, y añaden soberanía del dato, que en algunos sectores pesa tanto como el importe. La respuesta correcta para muchas pymes acaba siendo mixta, con lo elástico en la nube pública y lo constante en infraestructura propia.
Qué hacer las dos primeras semanas
Empieza por ver. Antes de tocar nada:
- Activa el desglose de coste por servicio y por etiqueta.
- Impón el etiquetado por entorno y proyecto a todo lo que se cree desde hoy.
- Pon un presupuesto con alerta.
Con dos semanas de esos datos ya se sabe qué palanca toca primero.
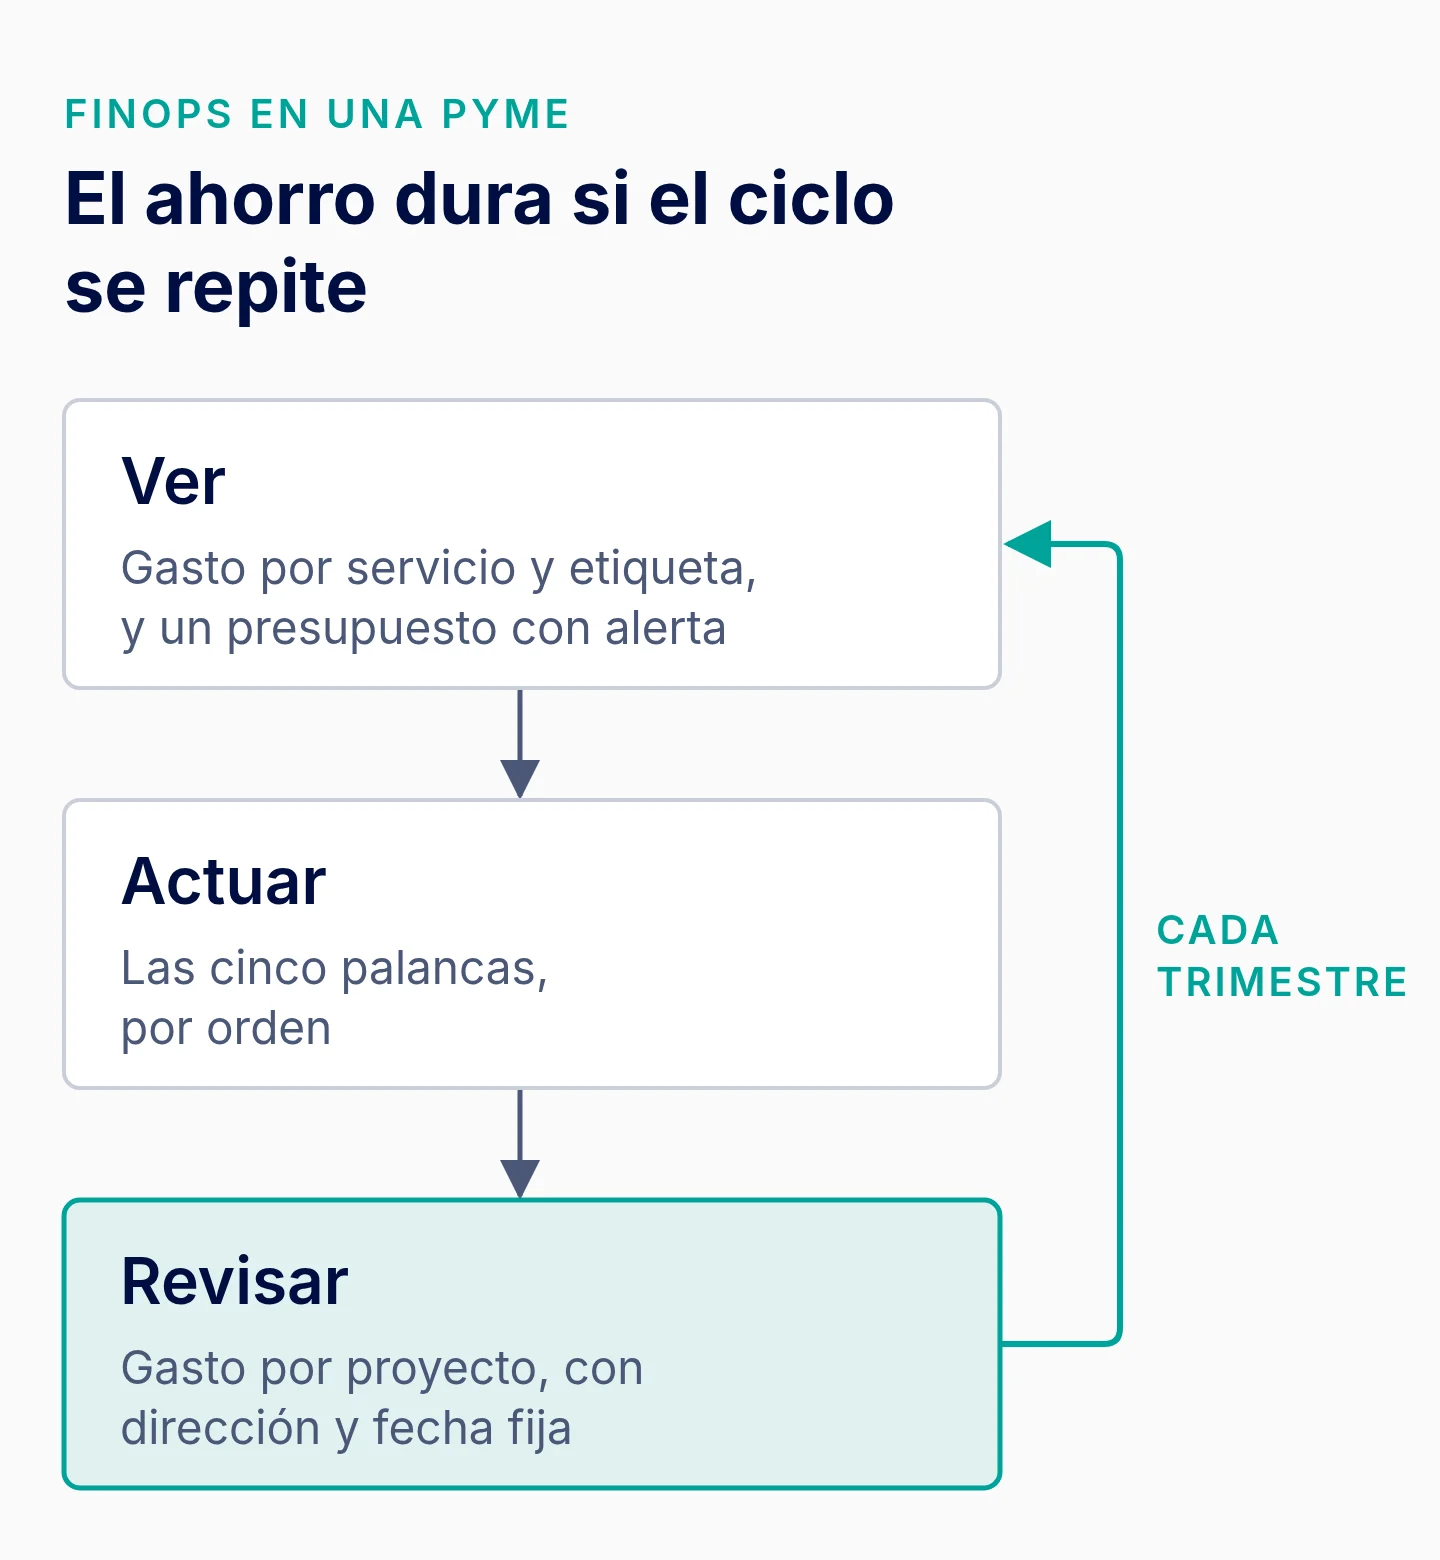
Lo difícil viene después de la primera pasada, cuando hay que evitar que el ahorro se deshaga en seis meses. Eso solo se consigue si alguien tiene la revisión en su calendario.
Si prefieres que esa responsabilidad esté en un contrato y no en la buena memoria de un técnico que ya va justo, es parte de nuestro servicio de cloud y AWS gestionado, con monitorización y guardia 24/7 opcional para incidencias críticas.
Pásanos el desglose de tu último mes y cuéntanos tu caso. Te decimos con datos qué palancas te aplican y cuánto pesa cada una antes de que contrates nada.
Si quieres el detalle práctico de cómo se leen y se controlan los importes mes a mes, lo contamos en cómo controlar el coste de tu factura de AWS.